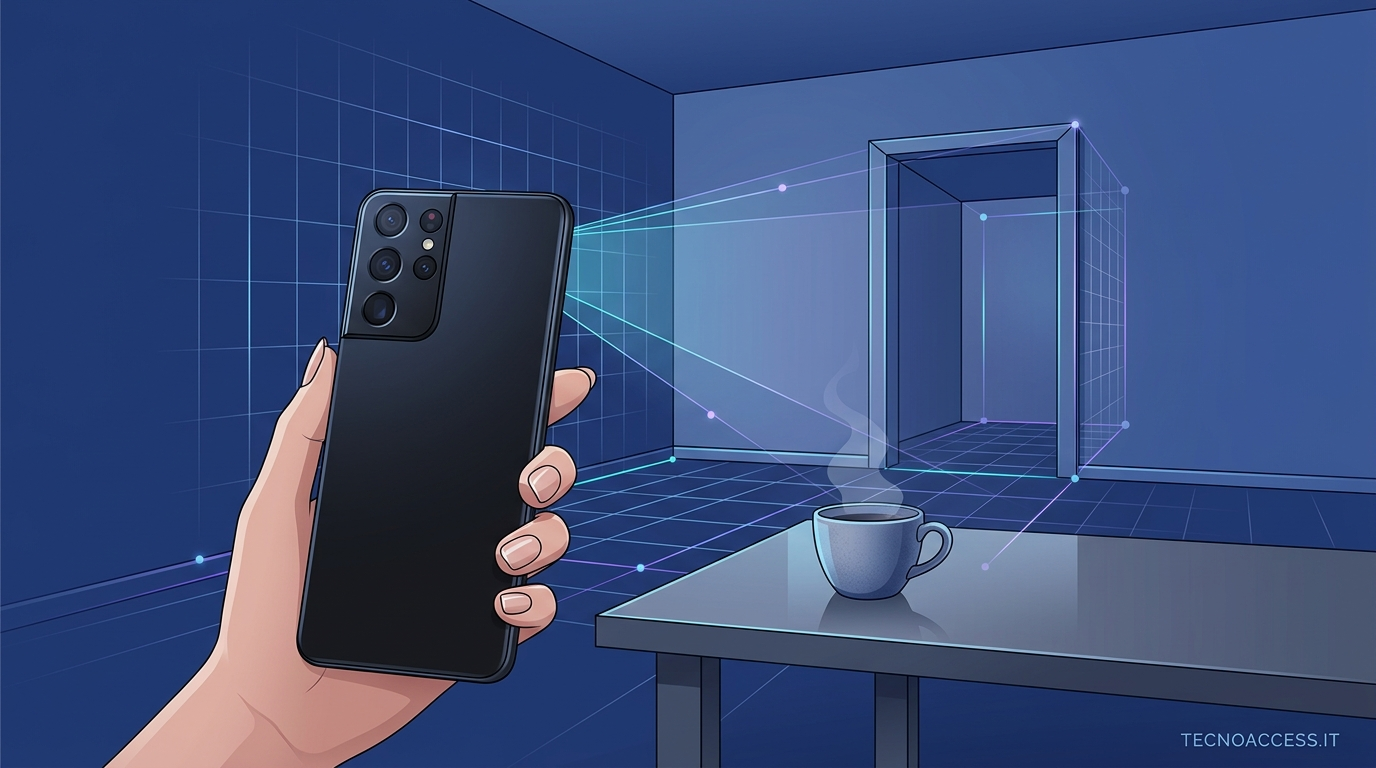
Google DeepMind rende disponibile l’architettura Gemini 4 Argon, una release mirata al potenziamento del ragionamento visivo nativo e all’analisi temporale dei flussi video. Il sistema introduce una migliore comprensione della tridimensionalità e delle relazioni spaziali tra gli oggetti: un traguardo tecnico che incide sulle applicazioni mobili destinate all’orientamento e alla lettura autonoma per persone con disabilità visiva.
Gli assistenti basati su fotocamera hanno spesso mostrato difficoltà nel calcolare distanze relative e nel mantenere la coerenza tra fotogrammi consecutivi. Gemini 4 Argon impiega un meccanismo di elaborazione video che tiene traccia degli elementi mentre l’utente sposta lo smartphone, evitando la perdita di contesto tra una richiesta e la successiva.
Comprensione spaziale e riduzione degli errori
Uno dei limiti più frequenti nelle risposte generate dai modelli multimodali è la tendenza a descrivere oggetti non presenti nell’inquadratura o a formulare ipotesi errate sulla loro collocazione. L’architettura Argon integra controlli di aderenza visiva che limitano le risposte agli elementi rilevati con certezza dai sensori ottici.
Nelle prove condotte su ambienti domestici e uffici, il modello localizza con precisione maniglie, prese elettriche e gradini, specificando se si trovano a destra o a sinistra rispetto all’asse della lente. Questa stima della posizione aiuta a orientare la mano verso l’oggetto desiderato senza dover compiere movimenti esplorativi alla cieca.
I ricercatori hanno affiancato all’analisi delle immagini i dati provenienti dai sensori inerziali del telefono, come giroscopio e accelerometro. Questa unione di parametri permette al modello di comprendere l’altezza a cui si trova il dispositivo, distinguendo un dislivello sul pavimento da un ostacolo sospeso all’altezza del capo.
Lettura di etichette e testi complessi in movimento
L’acquisizione di testi stampati su superfici curve, come bottiglie, confezioni di farmaci o scatolette alimentari, richiede la capacità di ricomporre porzioni di parole catturate da angolazioni diverse. Argon analizza i fotogrammi in successione e assembla le scritte frammentate prima di produrre la risposta vocale.
Il sistema separa la lettura del testo principale dalle avvertenze secondarie, segnalando subito date di scadenza o dosaggi quando vengono richiesti. La decodifica avviene mantenendo il testo isolato dal resto dell’immagine, facilitando l’esportazione su righe braille collegate via Bluetooth allo smartphone.
Nei test con illuminazione debole o riflessi di luce artificiale su superfici plastificate, il modello filtra i disturbi visivi ricostruendo i caratteri coperti dal bagliore, garantendo una lettura fluida anche negli ambienti di vendita della grande distribuzione.
Applicazioni per la mobilità e la guida della fotocamera
La combinazione di bassa latenza e calcolo geometrico apre nuove prospettive per le app di assistenza visiva in tempo reale. Durante il cammino all’aperto, il sistema riconosce passaggi pedonali, semafori con segnale acustico e cartelli di indicazione, fornendo indicazioni di direzione coerenti con la velocità del passo.
Un aspetto operativo rilevante riguarda i suggerimenti di puntamento: se l’utente inquadra solo parzialmente un documento o un display digitale, il modello comunica con frasi concise se alzare, abbassare o inclinare il dispositivo per completare l’inquadratura, evitando tentativi a vuoto.
Sotto il profilo dell’autonomia energetica, Gemini 4 Argon adotta un’architettura ibrida che distribuisce il carico di lavoro tra i chip neurali presenti a bordo del telefono e l’infrastruttura cloud. Le operazioni preliminari di filtraggio delle immagini e il tracciamento dei bordi avvengono sul dispositivo, limitando la trasmissione via rete ai soli dati semantici ad alto livello. Questo bilanciamento riduce il consumo della batteria durante le sessioni prolungate di navigazione a piedi.
Distribuzione e disponibilità per gli sviluppatori
Google distribuisce le librerie di Gemini 4 Argon all’interno della piattaforma Google AI Studio e tramite Vertex AI, con endpoint dedicati alla ricezione di flussi video compressi. Le aziende del settore tiflotecnico possono testare i nuovi modelli nei propri applicativi sperimentali.
Leggi la documentazione ufficiale di Gemini sul portale di Google DeepMind. La pagina elenca i requisiti di sistema, i parametri per le chiamate video in streaming e le linee guida per la privacy dei dati visivi.
Chiedi a Sonar su questo articolo
Sonar è l’assistente di TecnoAccess: risponde usando solo gli articoli della testata e ti dice sempre di quando è la cosa che racconta.
Iscriviti e ricevi il libro in regalo
Con l'iscrizione alla newsletter ricevi in regalo «AI e disabilità visiva 2026», il libro di Tecnoaccess sulle applicazioni dell'intelligenza artificiale per le persone cieche e ipovedenti. Disponibile in EPUB e PDF accessibile.
Ogni domenica alle 9 ricevi le notizie della settimana e un consiglio pratico su VoiceOver, NVDA o TalkBack riservato agli iscritti. Puoi annullare l'iscrizione dal link in fondo a ogni email.